Разговор о корпоративном ИИ часто начинается слишком грубо. Одни говорят: «Никаких внешних моделей, всё должно работать только внутри компании». Другие, наоборот, считают, что достаточно выдать сотрудникам доступ к ChatGPT — и вопрос решён. На практике обе крайности мешают.
Для бизнеса полезнее ставить вопрос иначе: не какую модель выбрать, а какие данные и какие действия вообще можно доверить тому или иному контуру. Потому что в одной и той же компании могут одновременно существовать совершенно разные сценарии.
Маркетолог просит помочь придумать варианты заголовков на основе уже опубликованной страницы сайта. Это одна ситуация. Сотрудник хочет быстро найти ответ во внутреннем регламенте отдела — уже другая. Инженер загружает в систему технические чертежи, описание нового изделия и результаты испытаний — третья. А если ИИ не просто читает данные, а собирается создать заказ, изменить запись в рабочей системе или подготовить платёж, то это уже четвёртый уровень риска.
Именно поэтому спор «локально или в облаке» сам по себе почти бесполезен. Компании нужен не абстрактный ответ, а понятная схема: какие данные можно обрабатывать во внешней модели, какие — только внутри, а какие процессы вообще нельзя обсуждать без прав доступа, журналирования и подтверждения человеком.
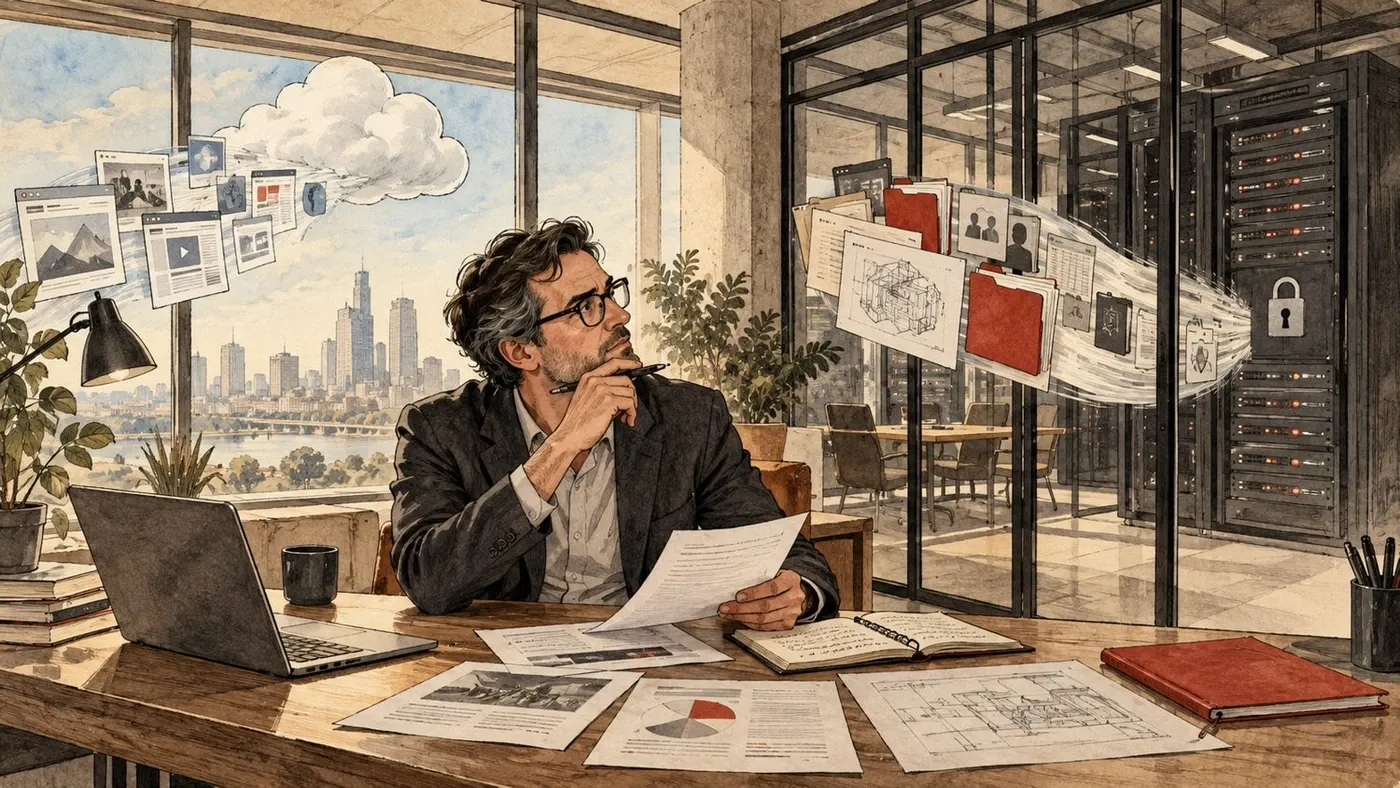
У компании редко бывает один тип данных. Обычно вопрос в том, что можно безопасно отдать наружу, а что должно остаться внутри.
Сначала классифицируйте данные, а не выбирайте железо
Когда бизнес задумывается о собственном ИИ-контуре, первая мысль часто техническая: нужен ли сервер, сколько памяти, какая модель поместится локально, хватит ли качества. Но начинать лучше не с сервера.
Первый шаг — разделить данные по чувствительности и по цене ошибки. То есть понять, какие материалы действительно можно считать публичными, какие являются внутренними рабочими документами, какие содержат коммерческую тайну или чувствительную служебную информацию, а какие ещё и связаны с действиями, меняющими состояние бизнеса.
Это разделение почти всегда даёт более полезный результат, чем обсуждение моделей. Потому что выясняется: не весь поток задач одинаков. Где-то компании вовсе не нужен свой закрытый контур. А где-то, наоборот, даже хорошая внешняя модель не решает главного вопроса — кто именно получает доступ к данным и что потом происходит с результатом.
Какие данные обычно можно отдавать наружу
Есть класс задач, где облачные модели действительно удобны и относительно безопасны. Как правило, это работа с уже опубликованными или заведомо некритичными данными.
Например, маркетолог просит подготовить варианты заголовков для статьи, сократить длинный абзац, придумать идеи для рекламного сообщения, предложить структуру лендинга на основе уже публичной информации о продукте. В таких случаях модель помогает как рабочий инструмент для текста, а цена ошибки и цена утечки невелики: информация и так не секретна.
Сюда же часто относятся задачи общего характера: резюмирование публичной статьи, подготовка черновика письма по типовой теме, поиск формулировок, генерация вариантов оформления, перевод открытых материалов, первичная работа с общедоступными исследованиями.
Важно понимать: речь не о том, что «в облако можно всё, что не жалко». Речь о том, что для некоторых сценариев сам риск действительно низкий, и ради них нет смысла строить сложную внутреннюю инфраструктуру.
Внутренние документы — уже другой разговор
Следующий уровень — внутренние регламенты, инструкции, рабочие описания процессов, непубличные коммерческие материалы, исторические переписки, отчёты, заметки проектных команд. Формально это может быть не коммерческая тайна в строгом юридическом смысле, но для компании такие документы уже составляют её внутренний контекст.
Здесь полезно думать не столько о модели, сколько о способе доступа. Сотруднику действительно может быть удобно задавать вопросы к внутренней базе знаний, быстро находить нужный порядок действий, резюмировать большой внутренний документ или сверять версии процедур. Но при этом уже возникает необходимость контролировать, кто именно имеет право читать эти документы, какие фрагменты доступны разным отделам и можно ли вообще отправлять такие данные во внешнюю модель.
Во многих компаниях именно здесь появляется первый аргумент в пользу собственного контура — не потому, что локальная модель магически лучше, а потому что бизнесу нужен контролируемый внутренний поиск и понятные границы доступа.
Конфиденциальные материалы требуют отдельной дисциплины
Есть и третий класс данных — исследования, рецептуры, конструкторская документация, финансовые модели, внутренние расчёты, непубличные условия сделок, клиентские массивы, чувствительные технические и продуктовые наработки. Здесь разговор о локальном ИИ уже становится гораздо более предметным.
Но здесь же важно не попасть в другую крайность — не думать, что локальное размещение автоматически решает вопрос безопасности. Если модель развёрнута внутри компании, но при этом имеет доступ ко всем папкам подряд, если права сотрудников не разделены, если журнал обращений к данным не сохраняется, если выгрузки и резервные копии лежат без контроля, то формально локальный контур может оказаться не менее рискованным, чем внешний сервис.
Локальность — это не панацея. Это только одно из условий. Кроме размещения данных, компании нужны роли, ограничения, сегментация, журналирование и понятный список того, какие документы вообще разрешено использовать в том или ином сценарии.
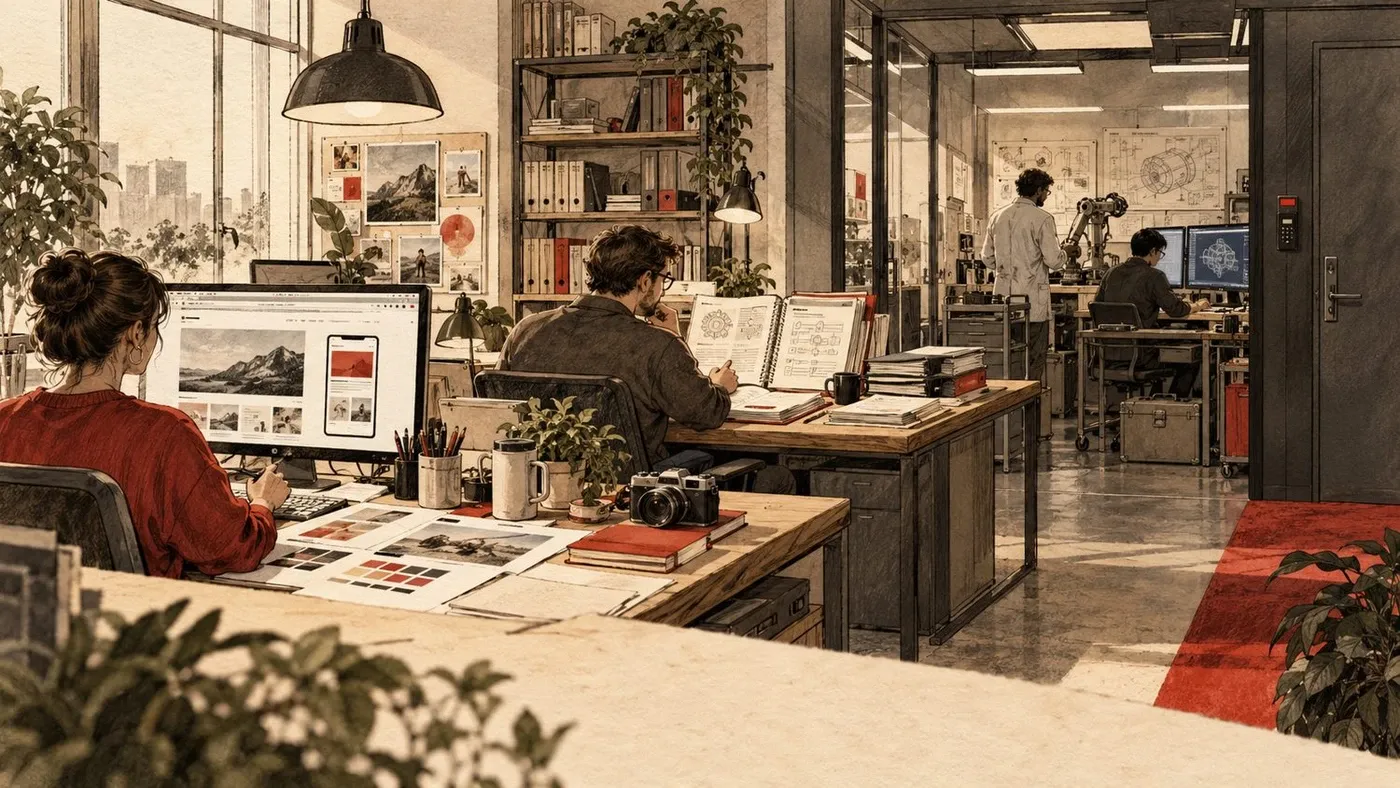
Не все данные в компании одинаковы: от публичных материалов до закрытых разработок и технических исследований.
Самый опасный класс — не данные, а действия
Есть ещё один уровень, о котором часто забывают, когда обсуждают только конфиденциальность. Даже если задача связана с вполне безопасными данными, ситуация меняется, когда ИИ получает право совершать действия.
Допустим, система прочитала заявку и собирается создать запись в рабочей системе. Или на основе документа хочет подготовить заказ. Или предлагает сформировать черновик платёжного поручения. Или пишет ответ клиенту от имени компании. В этот момент главный вопрос уже не только в том, где физически живут данные — локально или в облаке. Главный вопрос в том, что произойдёт после решения модели.
Поэтому полезно делить корпоративные сценарии не только на «публичные» и «секретные», но и на читающие и изменяющие. Читать внутренний документ — один риск. Создавать документ в ERP, менять статус заказа, запускать уведомление клиенту или готовить платёж — другой. И чем выше цена ошибки, тем сильнее растёт роль подтверждения человеком.
В этом смысле даже довольно хороший внутренний ИИ не должен автоматически получать право завершать весь процесс. Куда разумнее, когда он помогает: извлекает поля из документа, собирает черновик, готовит пояснение, находит нужный регламент, предлагает решение — а окончательное действие делает сотрудник.
Хорошая архитектура обычно гибридная
Именно здесь становится видно, почему полезнее думать категориями маршрутизации, а не религиозного выбора «только локально» или «только облако».
На практике разумная архитектура часто выглядит гибридно. Публичные и малорисковые задачи могут спокойно решаться через внешнюю модель. Внутренние документы — через контролируемую корпоративную базу знаний и выбранную модель, локальную или изолированную. Конфиденциальные технические и продуктовые материалы — через внутренний контур с ограниченным доступом. А процессы, меняющие рабочие системы, вообще должны проектироваться вместе с правами, журналами и точками ручного подтверждения.
Такой подход хорош тем, что компании не приходится тащить всю нагрузку внутрь только из принципа. Там, где внешняя модель удобнее и не создаёт существенного риска, её можно использовать. А там, где данные и последствия действительно чувствительны, есть отдельная более строгая схема.
Что нужно решить до покупки сервера
Компании, которая впервые думает о собственном ИИ-контуре, полезнее не сразу заказывать железо, а сначала ответить на несколько практических вопросов.
Какие типы данных вообще будут использоваться? Какие из них уже публичны, а какие внутренние? Есть ли коммерческая тайна, технические разработки, чувствительные клиентские или финансовые данные? Какие отделы будут пользоваться системой? Нужно ли им видеть одно и то же? Должен ли ИИ только отвечать на вопросы, или он будет что-то создавать, изменять и отправлять? Где цена ошибки низкая, а где она уже затрагивает деньги, обязательства перед клиентом или производственный процесс?
Пока нет ответов на эти вопросы, разговор о выборе модели почти всегда преждевременный.
Локальный ИИ — это не только про секретность, но и про предсказуемость
У собственного контура есть и другие достоинства. Компании бывает важно не зависеть полностью от внешнего поставщика, от его ограничений, тарифов и изменений в политике доступа. Внутренний контур удобен там, где нужен более стабильный и управляемый процесс: например, в длительной работе с определённым массивом документов, в проектах, требующих интеграции с внутренними системами, или там, где важна воспроизводимость и журналирование.
Но и здесь стоит помнить о здравом балансе. Не каждая задача оправдывает локальную инфраструктуру. Если компания будет использовать внутреннюю модель только для редких простых текстовых запросов, вся эта конструкция может оказаться дороже и сложнее, чем польза от неё.
Сначала — задачи и данные. Потом — архитектура.
Как выглядит хороший первый пилот
Если компания только подходит к теме, лучше не начинать со всеобъемлющего «корпоративного ассистента». Намного полезнее выбрать один ограниченный сценарий и проверить его на практике.
Хороший первый пилот обычно отвечает нескольким условиям. Во-первых, в нём есть понятный круг пользователей. Во-вторых, легко описать тип данных. В-третьих, цена ошибки не катастрофична. В-четвёртых, можно заранее определить, что считать успешным результатом.
Например, один из разумных пилотов — внутренний поиск по регламентам определённого подразделения. Другой — работа с конкретным набором технических документов в отдельной проектной группе. Третий — безопасная подготовка черновиков документов без права на финальное проведение или отправку.
Во всех этих случаях важно не только качество ответов модели. Важно, кто видит данные, как выдаются права, остаётся ли журнал действий, как система сообщает о неуверенности и в какой момент к процессу подключается человек.
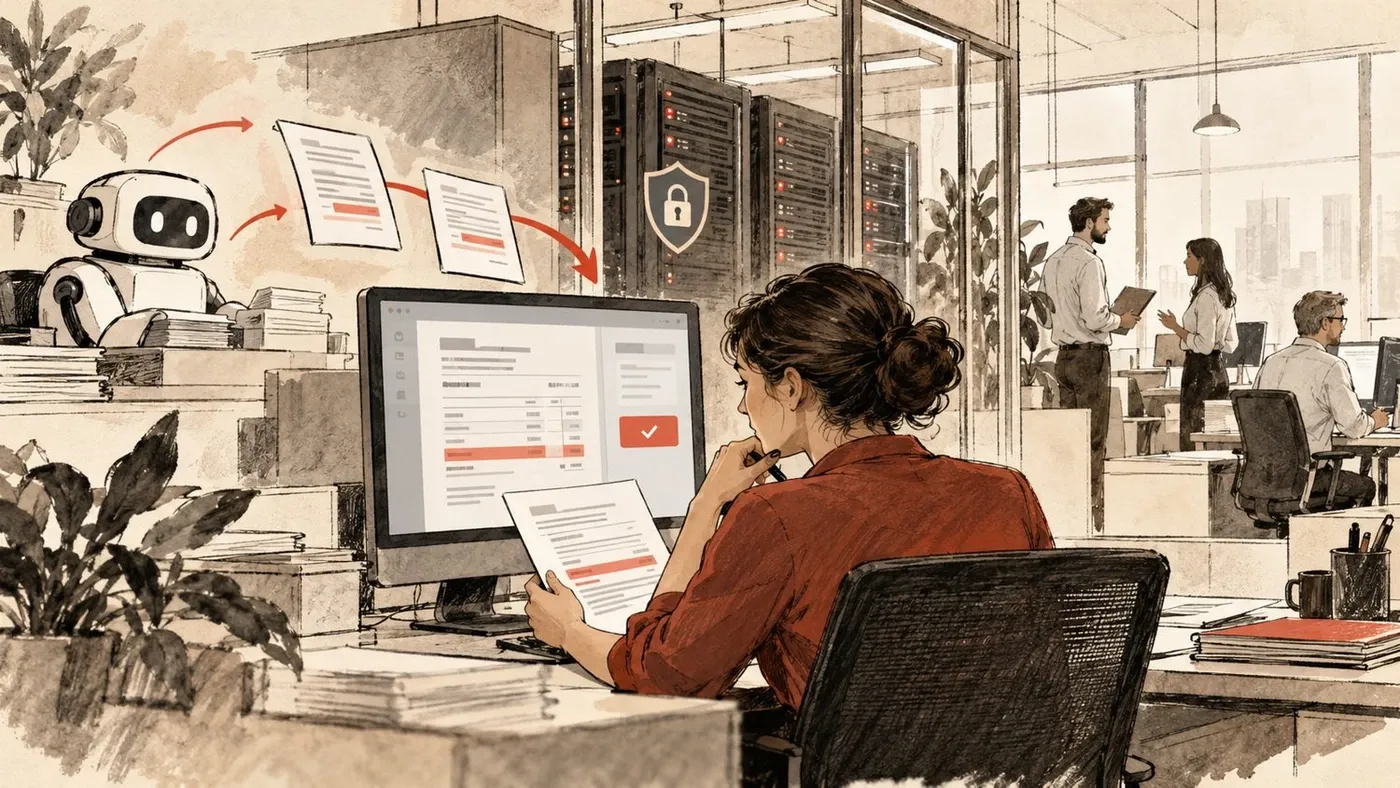
Критические действия лучше строить по принципу «ИИ готовит, человек утверждает», а не наоборот.
С чего начинать бизнесу
Если упростить всё до одного практического вывода, он будет таким: не выбирайте между облаком и локальной моделью вслепую. Сначала разберите данные и операции.
Составьте список реальных сценариев, в которых сотрудники хотят использовать ИИ. Разделите их по чувствительности данных. Отдельно выделите задачи, где модель только читает и помогает, и задачи, где она влияет на состояние систем. Определите, где допустима внешняя модель, где нужен внутренний контур, а где вообще нельзя обходиться без подтверждения человеком.
После такого разбора почти всегда становится видно, что компании не нужен ни тотальный запрет, ни тотальная свобода. Ей нужна разумная карта: что можно отдавать наружу, что должно оставаться внутри, и где проходит граница между помощью ИИ и полномочиями сотрудника.
Именно с такой карты и стоит начинать ИИ-аудит. Не с сервера, не с названия модели и не с модного слова «агент», а с вопроса: какие данные мы готовы доверить системе и что мы вообще хотим, чтобы она делала с этими данными.
